2026. 9. 25. 13:24ㆍ사회경제 분석
이번 포스팅에서는 청년이 모이는 지역들의 공통점을 살펴보겠습니다. 청년 인구 이야기를 하다 보면 수도권과 비수도권을 먼저 나누게 되는데요. 같은 수도권 안에서도 지역의 모습은 다르고, 지방 도시와 군 지역도 하나로 묶기에는 차이가 있습니다.
그렇다면 행정구역 대신 실제 지역의 특성을 기준으로 묶어보면 어떨까요? 이번에는 머신러닝 방법 중 하나인 군집분석을 이용해 비슷한 지역들을 나누고, 각 유형에서 청년의 이동이 어떻게 나타나는지 확인해보겠습니다.
1. 청년이 모인다는 것을 어떻게 확인할까?
먼저 청년이 많이 살고 있는 것과, 최근에 청년이 들어오고 있는 것은 구분할 필요가 있습니다. 이번 글에서는 후자를 보기 위해 청년순이동률을 사용하겠습니다. 사용한 KOSIS e-지방지표의 설명에 따른 청년 범위는 19~34세입니다.
청년순이동률(%) = (19~34세 전입자 수 − 전출자 수) ÷ 19~34세 연앙인구 × 100
연앙인구는 해당 연도 중간 시점의 인구를 뜻합니다. 순이동률이 양수이면 들어온 청년이 나간 청년보다 많고, 음수이면 반대입니다. 인구가 큰 지역에 유리한 단순 이동 인원 대신, 해당 연령 인구 대비 비율로 비교하는 것입니다. 출생이나 연령대 진입·이탈까지 포함한 청년 인구 전체의 증감률과는 다릅니다.
자료는 KOSIS e-지방지표의 2024년 자료를 사용했습니다. 인구·가구·주거·사업체 자료의 기준 연도를 맞추고, 다섯 지표가 모두 확인되는 211개 지역을 분석했습니다. 시·군·자치구와 제주 행정시를 포함하며, 수원시처럼 일반구가 있는 도시는 시 단위로 비교했습니다.
분석 범위: 이용한 시군구 조회 자료에 세종이 포함되지 않았고, 전남 17개 군은 청년순이동률·종사자 지표가 함께 확인되지 않아 제외했습니다. 이 지역들을 0으로 처리하거나 다른 지역 값으로 채우지는 않았습니다. 따라서 결과는 자료가 확보된 211개 지역에 대한 비교이며, 전국 모든 지역을 대표하는 결과로 확대해석하기는 어렵습니다.
2. 어떤 기준으로 비슷한 지역을 묶을까?
군집분석에 넣을 지역 특성은 아래 네 가지로 정했습니다. 인구 구성, 가구 구성, 지역 내 종사자의 규모, 주택의 연식을 함께 보기 위한 선택입니다.
| 지표 | 살펴보려는 지역 특성 |
|---|---|
| 고령인구 비율(%) | 전체 인구 중 만 65세 이상 인구의 비중 |
| 1인가구 비율(%) | 일반가구 중 혼자 사는 가구의 비중 |
| 인구 천명당 종사자 수(명) | 주민등록인구 대비 지역 내 사업체 종사자의 규모 |
| 노후주택 비율(%) | 전체 주택 중 30년 이상 된 주택의 비중 |
여기서 종사자 수는 그 지역에 사는 사람들의 취업률과는 다릅니다. 다른 지역에서 출근하는 사람도 포함될 수 있으므로, 인구 천명당 종사자 수가 1,000명을 넘을 수도 있습니다. 또한 1인가구는 청년만을 뜻하지 않고, 노후주택 비율은 집값이나 월세를 직접 측정하는 지표가 아닙니다.
청년순이동률은 지역을 묶는 과정에 넣지 않았습니다. 청년이 많이 들어오는 지역끼리 먼저 묶고 나서 “이 유형에 청년이 많이 들어온다”고 설명하면 분석이 순환하기 때문입니다. 지역의 특성으로 먼저 묶은 뒤, 청년순이동률은 결과를 비교할 때 사용하겠습니다.
방법은 K-means입니다. 비슷한 특성을 가진 지역들을 같은 집단에 넣고, 각 집단의 중심과 소속 지역 사이의 거리가 작아지도록 묶는 방법입니다. 미리 “도시형”, “농촌형” 같은 정답을 주지 않는다는 점에서 비지도학습에 해당합니다.
다만 지표들의 숫자 크기가 다릅니다. 종사자 수는 수백~수천 명 단위이고, 나머지는 % 단위이므로 그대로 넣으면 숫자가 큰 지표가 거리에 더 큰 영향을 줄 수 있습니다. 종사자 수에는 먼저 log(1+x)를 적용해 큰 값 사이의 차이를 완화하고, 네 지표 모두 평균 0·표준편차 1이 되도록 표준화했습니다. 표준화 후에는 네 지표에 같은 가중치를 부여했습니다.
표준화한 값 = (해당 지역의 값 − 분석 대상 지역의 평균) ÷ 표준편차
유형 수는 2~6개를 비교했습니다. 같은 유형 안에서 얼마나 비슷하고 다른 유형과 얼마나 구분되는지를 보는 실루엣 점수가 가장 높은 3개 유형을 선택했습니다. 점수는 0.346으로, 지역들이 완전히 뚜렷하게 갈린다는 의미는 아닙니다. 초기 중심을 100번 바꿔 계산한 결과 중 각 지역과 소속 집단 중심 사이 거리의 제곱합이 가장 작은 결과를 사용했습니다.
3. 지역들은 어떻게 나뉘었을까?
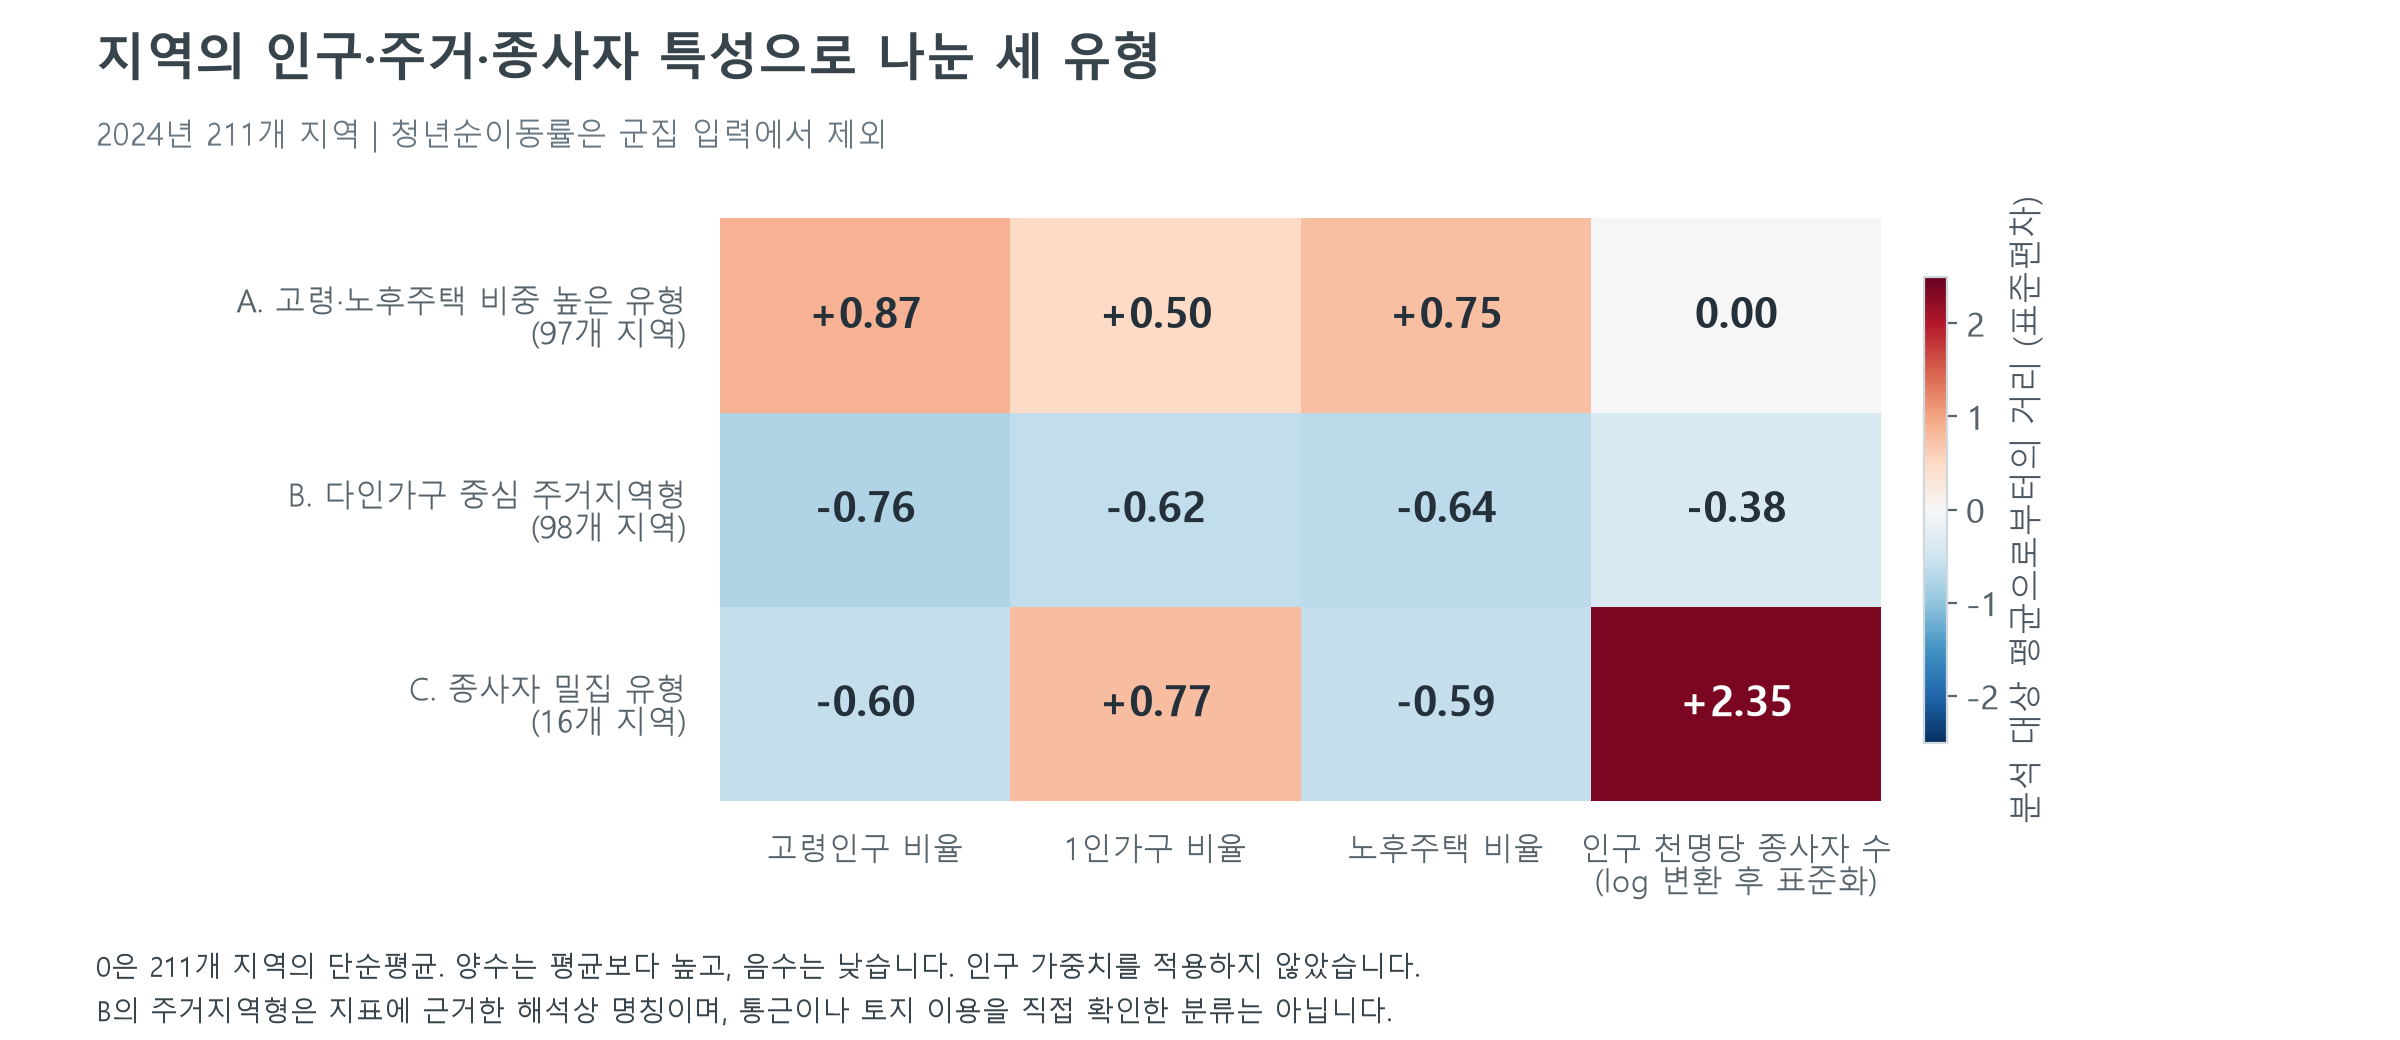
그림 1. 입력 지표의 유형별 평균. 종사자 수는 log(1+x)를 적용한 뒤 표준화했습니다.
위 그림에서 0은 분석 대상 지역의 평균입니다. 양수는 평균보다 높고, 음수는 낮다는 의미입니다. 지역마다 인구 규모와 관계없이 같은 가중치를 주었습니다. A·B·C의 이름은 각 군집의 평균적인 특징을 보고 붙인 해석상 명칭입니다. 모든 소속 지역이 같은 모습을 보인다는 뜻이나, 지역의 좋고 나쁨을 매긴 순위는 아닙니다.
A. 고령·노후주택 비중 높은 유형 — 97개 지역
고령인구 비율은 평균 33.5%, 노후주택 비율은 42.9%입니다. 쉽게 말하면 고령인구와 오래된 주택의 비중이 큰 지역들입니다. 여기서 오래된 주택은 30년 이상 된 주택을 뜻합니다. 경북 영천시, 경남 밀양시, 전북 정읍시 등이 이 유형의 중심에 가까운 지역으로 나타났습니다. 인구와 주택의 구성을 요약한 유형이므로, 이것만으로 일자리가 부족하거나 모든 지역이 쇠퇴하고 있다고 단정하기는 어렵습니다.
B. 다인가구 중심 주거지역형 — 98개 지역
고령인구 비율은 평균 18.8%, 1인가구 비율은 34.3%입니다. 두 지표가 각각 낮다는 의미이며, “혼자 사는 고령자가 적다”는 뜻은 아닙니다. 1인가구 비율을 뒤집어 보면 2인 이상 가구의 비중이 약 65.7%라는 뜻입니다. 노후주택 비율은 25.1%, 인구 천명당 종사자 수는 449.8명으로, 두 지표도 분석 대상 지역의 평균보다 낮았습니다.
이 특징들을 함께 읽으면 고령화와 주택 노후화가 상대적으로 덜하고, 다인가구의 거주 성격이 두드러지는 지역군으로 해석할 수 있습니다. 다만 “주거지역형”은 가구·주택·종사자 지표를 바탕으로 붙인 잠정적인 이름입니다. 주거용 토지 비율이나 지역 밖으로의 통근을 직접 확인한 것은 아니므로, 신도시나 베드타운으로 확정해서 부르기는 어렵습니다. 고령인구가 적다고 청년 비율이 반드시 높은 것도 아니며, 2인 이상 가구에 자녀가 있는지도 이번 자료로는 알 수 없습니다.
대구 달서구·북구, 제주 제주시 등이 B 유형의 중심에 가까웠고, 경기 양주시도 같은 유형에 포함되었습니다. 지역적 배경이 서로 다른 곳들이 네 지표에서는 비슷하게 묶인 것입니다. 따라서 B는 네 지표로는 지역의 성격을 하나로 선명하게 규정하기 어려운, 내부 차이가 큰 유형으로 읽는 것이 적절하겠습니다. 뒤에서 살펴볼 청년의 이동 방향도 이 유형 안에서 크게 달랐습니다.
C. 종사자 밀집 유형 — 16개 지역
인구 천명당 종사자 수가 평균 1,221.6명으로 높았습니다. 쉽게 말하면 거주인구에 비해 사업체에서 일하는 사람이 많이 모인 지역들입니다. 다른 지역에서 출근하는 사람도 종사자에 포함되기 때문에 1,000명을 넘을 수 있으며, 주민의 취업률을 뜻하지는 않습니다. 서울 영등포구, 대구 중구와 함께 충북 음성군도 포함됩니다. 도심의 구와 군 지역이 함께 들어갈 수 있다는 점에서, 행정구역의 종류보다 주민 수 대비 종사자의 집중도가 이 유형의 핵심이라고 볼 수 있습니다.
지역 유형을 지도에 표시하면 아래와 같습니다. 위치 자체를 군집분석에 넣지는 않았지만, 비슷한 특성의 지역들이 지리적으로도 모여 있는 모습을 확인할 수 있습니다.
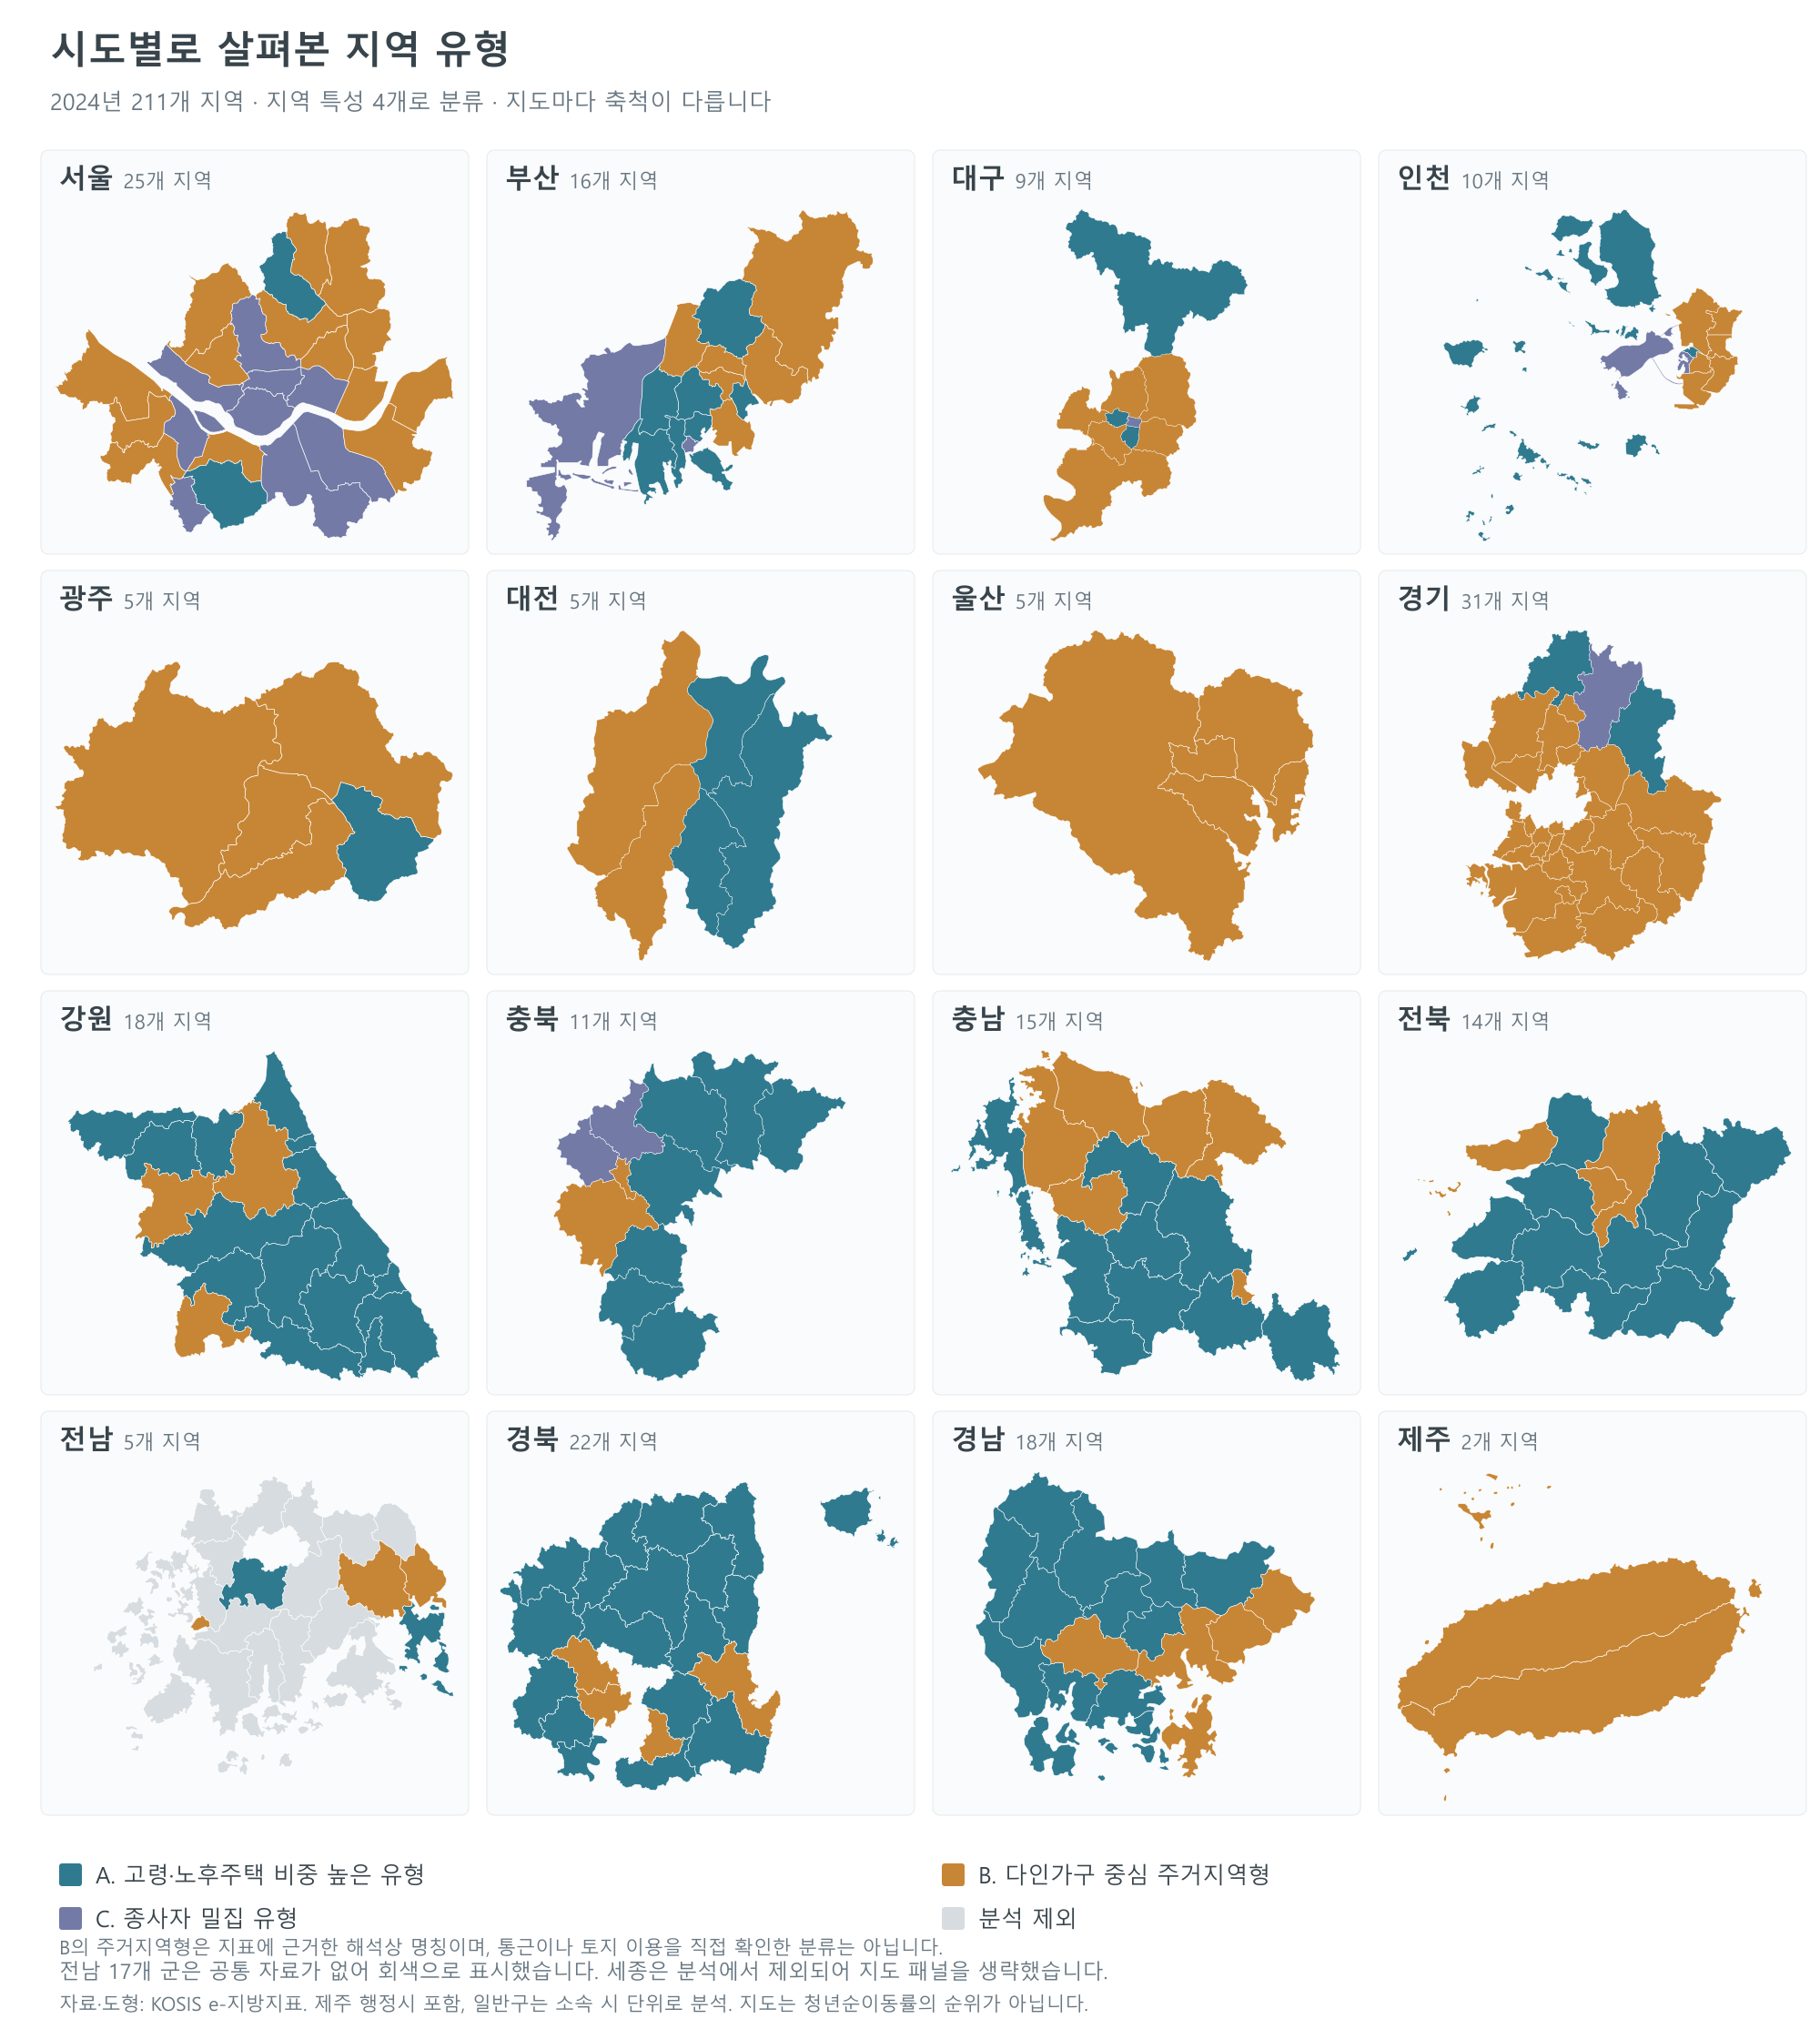
그림 2. 지역 유형의 분포. 패널별 축척이 다르며, 색은 청년순이동률이 아니라 지역 특성에 따른 군집을 뜻합니다.
4. 어느 유형에 청년이 들어왔을까?
이제 지역을 나눌 때 제외했던 청년순이동률을 비교해보겠습니다. 아래 그림의 점 하나가 지역 하나이고, 큰 마름모는 유형별 중앙값입니다.
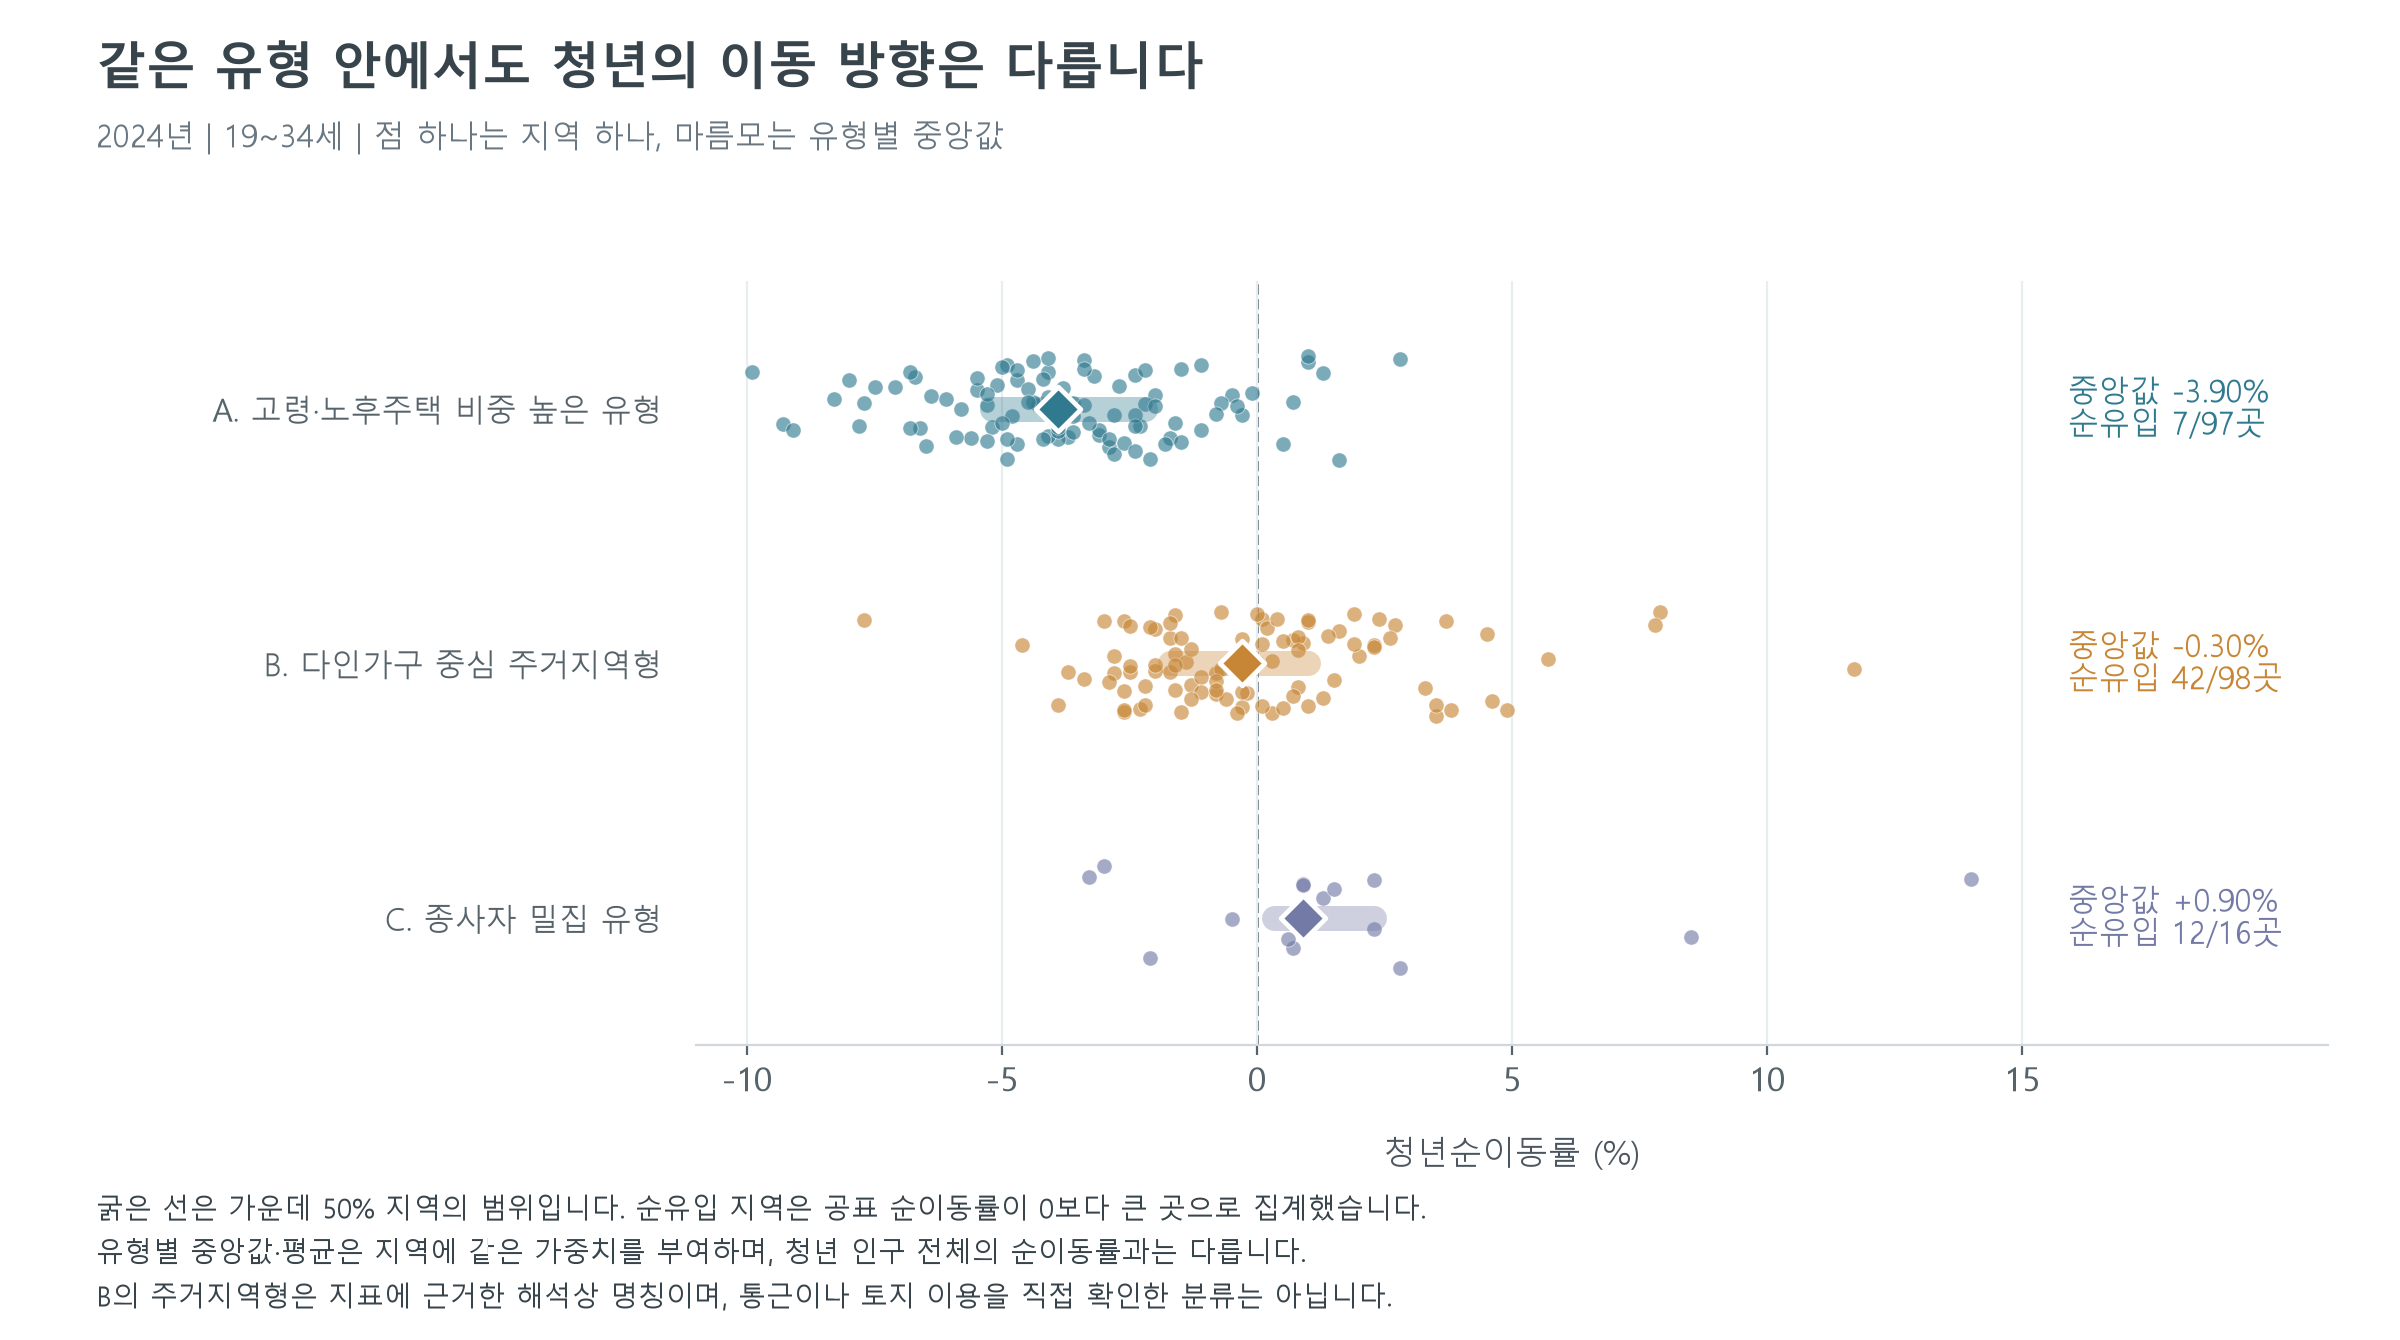
그림 3. 점은 지역별 공표 순이동률, 마름모는 중앙값, 굵은 선은 25~75백분위 구간입니다.
| 유형 | 청년순이동률 평균 | 중앙값 | 순유입 지역 수 |
|---|---|---|---|
| A. 고령·노후주택 비중 높은 유형 | -3.73% | -3.90% | 7/97곳 (7.2%) |
| B. 다인가구 중심 주거지역형 | +0.02% | -0.30% | 42/98곳 (42.9%) |
| C. 종사자 밀집 유형 | +1.73% | +0.90% | 12/16곳 (75.0%) |
평균과 중앙값은 지역별 공표 순이동률을 같은 가중치로 요약한 값입니다. 유형에 속한 전체 청년 인구를 합쳐 계산한 순이동률은 아닙니다. 공표값이 0보다 큰 지역을 순유입으로 집계했으며, 원자료가 소수 첫째 자리까지 제공되므로 0.0인 지역의 미세한 이동 방향은 구분하지 않았습니다.
종사자 밀집 유형에서는 16곳 중 12곳이 청년 순유입으로 나타났습니다. 중앙값은 +0.90%였습니다. 반면 고령·노후주택 비중 높은 유형의 중앙값은 -3.90%였고, 97곳 중 90곳에서 순유출이 나타났습니다.
B 유형은 평균이 +0.02%로 0에 가깝지만, 중앙값은 -0.30%였습니다. 경기 양주시(+11.7%)처럼 높은 순유입률을 기록한 곳과, 경북 칠곡군(-7.7%)처럼 순유출이 나타난 곳이 함께 포함되어 있기 때문입니다. 평균 하나만 보면 이 차이를 놓치기 쉽습니다.
C 유형 안에서도 서울 영등포구는 +2.8%, 충북 음성군은 +0.6%였지만, 부산 중구는 -3.0%였습니다. A 유형에 속한 경북 안동시는 +2.8%로 순유입이었습니다. 같은 지역 특성을 가진 유형이라고 해서 청년의 이동 방향까지 같지는 않았습니다.
5. 이 결과로 어디까지 말할 수 있을까?
이번 자료에서는 종사자가 상대적으로 밀집한 유형에 청년 순유입 지역이 더 많이 포함되어 있었습니다. 고령인구와 오래된 주택의 비중이 높은 유형에서는 순유출이 더 넓게 나타났습니다. 지역을 수도권과 비수도권으로만 나누었을 때와는 다른 방식으로 공통점과 차이를 살펴본 것입니다.
다만 “사업체 종사자를 늘리면 청년이 들어온다”는 인과관계까지 확인한 것은 아닙니다. 청년의 과거 이동이 현재의 고령인구 비율이나 가구 구성에 영향을 주었을 수도 있습니다. 지역의 임금·주거비·대학·교통·주택 공급 등 이번에 넣지 않은 조건도 함께 살펴볼 필요가 있습니다.
군집의 이름과 소속도 분석에 사용한 변수와 기준에 따라 달라질 수 있습니다. 초기값을 바꾸고 극단적인 값의 영향을 줄인 경우에도 분류가 대체로 유사했지만, 네 지표만으로 지역의 성격을 모두 설명할 수는 없습니다. 자료가 빠진 지역이 있고, 같은 연도의 관찰값을 비교한 탐색적 분석이라는 점도 함께 기억해야겠습니다.
이번 포스팅에서는 머신러닝을 이용해 비슷한 지역을 먼저 묶고, 청년의 이동을 나중에 비교해보았습니다. 다음에는 같은 유형에 속하면서도 청년 이동 방향이 달랐던 지역을 골라, 어떤 조건에서 차이가 생겼는지 조금 더 자세히 살펴볼 수 있을 것 같습니다.
6. 파이썬으로 직접 계산하기
정리한 자료는 지역별로 한 행씩 구성했습니다. 아래 코드는 네 지표만 사용해 유형 수를 선택한 뒤, 청년순이동률의 평균과 중앙값을 계산하는 부분입니다. CSV의 군집 결과 열이 있더라도 학습에는 넣지 않습니다.
import numpy as np
import pandas as pd
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans
from sklearn.metrics import silhouette_score

df = pd.read_csv("data/analysis_data.csv", dtype={"regionCd": str})
features = ["elderly", "single", "old_housing", "jobs_per_1000"]

X = df[features].copy()  # 청년순이동률은 제외
X["jobs_per_1000"] = np.log1p(X["jobs_per_1000"])
Z = StandardScaler().fit_transform(X)

models, scores = {}, {}
for k in range(2, 7):
    model = KMeans(n_clusters=k, n_init=100, random_state=42).fit(Z)
    models[k] = model
    scores[k] = silhouette_score(Z, model.labels_)

best_k = max(scores, key=scores.get)
df["group"] = models[best_k].labels_

# 유형을 정한 다음에 청년순이동률 비교
result = df.groupby("group")["youth_net"].agg(
    n="size", mean="mean", median="median",
    net_inflow_regions=lambda x: (x > 0).sum()
)
print("선택한 유형 수:", best_k)
print(result.to_string(float_format=lambda v: f"{v:.2f}"))
자료 및 분석 메모
자료 확인일은 2026년 9월 24일입니다. 각 지표는 KOSIS e-지방지표 화면에서 2024년 연간 값을 선택해 조회했으며, 지역 코드로 결합했습니다. 연도는 같지만 인구·가구·주택·사업체 통계의 조사 기준 시점과 분모는 서로 다를 수 있습니다.
고령인구 비율: e-지방지표 화면 · 원 통계표 DT_1YL20631
1인가구 비율: e-지방지표 화면 · 원 통계표 DT_1YL21161
노후주택 비율: e-지방지표 화면 · 원 통계표 DT_1YL202004
인구 천명당 종사자 수: e-지방지표 화면 · 원 통계표 DT_1YL20852
청년순이동률: e-지방지표 화면 · 원 통계표 DT_1YL20642
표와 그림은 공표된 값을 사용해 계산했습니다. 요약 통계의 소수 둘째 자리는 지역별 공표값을 평균·집계하는 과정에서 생긴 자리이며, 원자료의 측정 정밀도가 높아졌다는 의미는 아닙니다. 순이동은 국내의 전입·전출을 기준으로 합니다.
누락 지역: 세종 및 전남 담양군, 전남 곡성군, 전남 구례군, 전남 고흥군, 전남 보성군, 전남 화순군, 전남 장흥군, 전남 강진군, 전남 해남군, 전남 영암군, 전남 무안군, 전남 함평군, 전남 영광군, 전남 장성군, 전남 완도군, 전남 진도군, 전남 신안군. 누락은 이번에 확보한 자료 범위의 문제이며, 해당 지역에 청년 이동이나 사업체 종사자가 없다는 뜻은 아닙니다.
재현 설정: K-means++, random_state=42, n_init=100, k=2~6 중 평균 실루엣 최대값 선택. 초기값 0~9에서 기준 분류와의 조정 랜드 지수(ARI)는 0.980~1.000, 각 입력 지표의 하위·상위 1%를 경곗값으로 제한한 경우에는 0.962였습니다. ARI는 1에 가까울수록 두 분류가 비슷하다는 뜻이며, 인과관계나 예측 정확도의 지표는 아닙니다.
'사회경제 분석' 카테고리의 다른 글
| 유가와 주유소 가격의 관계 (0) | 2026.09.27 |
|---|---|
| 물가와 실업률의 관계 (0) | 2026.09.26 |
| 금값이 오른 걸까, 환율이 올린 걸까? 금값(원화기준)의 상승분 분해 (0) | 2026.09.20 |
| 서울 아파트 매매·전세가격의 공적분 분석 (1) | 2026.09.15 |
| 금리와 원·달러 환율의 관계 분석(VAR를 활용한) (1) | 2026.09.13 |